
Dezembro de 2017. A equipe da DeepMind publica um artigo de pesquisa e, no apêndice, dez partidas comentadas. Essas dez partidas entusiasmaram a comunidade do xadrez de uma maneira que nada havia feito desde o match Fischer–Spassky de 1972.
Não era apenas um programa vencendo outro. Era a maneira como vencia.
A arquitetura de AlphaZero
Para entender por que AlphaZero representa uma ruptura, é preciso compreender o que faz e o que não faz.
AlphaZero é um sistema de aprendizado por reforço profundo, ou deep reinforcement learning. Combina duas tecnologias:
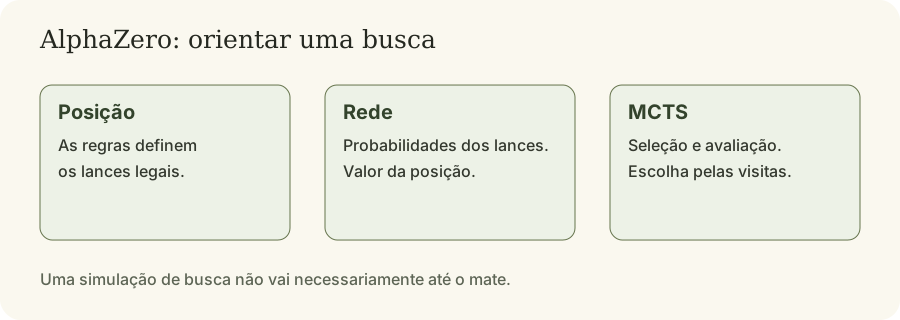
Uma rede neural profunda que recebe a posição do tabuleiro como entrada e produz duas saídas: uma distribuição de probabilidade sobre os lances legais, a policy head, indicando quais parecem promissores, e um valor entre -1 e +1 que estima o resultado do ponto de vista do jogador com a vez, a cabeça de valor.
A busca em árvore Monte Carlo, MCTS, que usa a rede neural para guiar a busca. Em vez de explorar exaustivamente a árvore de jogo com poda alfa-beta, MCTS seleciona caminhos até as folhas da árvore explorada; a rede fornece ali uma avaliação que é propagada até a raiz. Essas simulações não são todas jogadas até o mate.
O destaque: AlphaZero recebeu apenas as regras do jogo. Nenhuma partida humana. Nenhuma heurística posicional. Nenhuma base de finais. Nenhum conhecimento do que seria uma posição “boa”, mas com uma representação, uma arquitetura e um procedimento de treinamento concebidos pelos pesquisadores.
Jogou 44 milhões de partidas contra si mesmo em cerca de nove horas, ajustando os pesos da rede durante o treinamento. As “nove horas” merecem uma precisão, pois costumam ser citadas como se fosse uma conquista econômica: nesse período, 5.000 TPUs de primeira geração geravam as partidas e 16 TPUs de segunda geração treinavam a rede no protocolo de 2018, contra 64 no preprint de 2017. Não era um computador em uma garagem. Ao final, desenvolveu uma maneira de jogar que ninguém havia programado explicitamente.
O match: 28 vitórias, nenhuma derrota e 72 empates
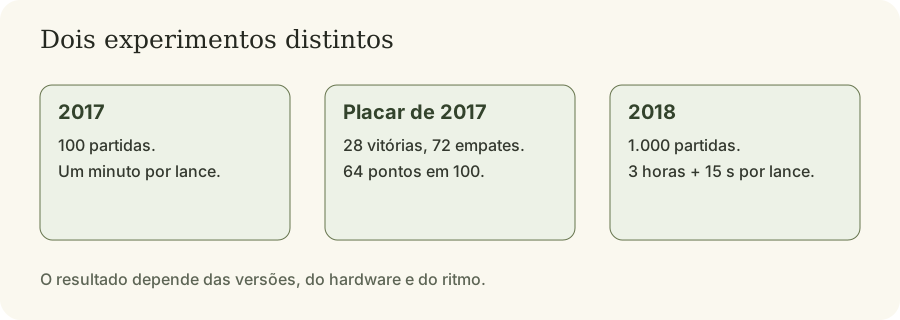
No match de dezembro de 2017, AlphaZero jogou cem partidas contra Stockfish 8, a melhor versão na época. Resultado: 28 vitórias de AlphaZero, 72 empates e nenhuma derrota. Com as brancas, foram 25 vitórias e 25 empates; com as pretas, três vitórias e 47 empates.
Um esclarecimento sobre o ritmo, pois é o erro mais comum sobre esse match: não era um controle de tempo clássico. Cada programa dispunha de um minuto fixo de reflexão por lance. Isso muda a leitura do resultado, porque Stockfish não podia administrar o tempo, distribuir o esforço pelos lances críticos ou pensar durante o tempo adversário. Sua gestão do tempo, parte de sua força, ficou fora de ação.
O resultado impressiona por vários aspectos. Um programa vencer Stockfish sem perder uma única partida é extraordinário; Stockfish 8 já era muito superior a qualquer humano. E as vitórias não eram apenas técnicas em finais complicados: eram construídas em temas posicionais claros.
Existem críticas legítimas às condições do match:
- Stockfish rodava sem bases de finais e sem livro de aberturas
- Seu espaço de hash estava limitado a 1 GB, pouco para 64 threads
- O tempo fixo de um minuto por lance neutralizava sua gestão do tempo
- As TPUs de AlphaZero não são diretamente comparáveis às CPUs de Stockfish
Essas críticas levaram a DeepMind a publicar em dezembro de 2018 uma versão revista e avaliada por pares em Science, com condições mais robustas: mil partidas, três horas por partida mais quinze segundos por lance, 44 núcleos para Stockfish e a versão campeã do TCEC 2016.
O resultado confirma a superioridade de AlphaZero nessas condições, mas a diferença diminui: 155 vitórias, seis derrotas e 839 empates em mil partidas, cerca de 57,5% dos pontos. Está longe do 28 a zero de 2017. AlphaZero também venceu Stockfish a partir de cada uma das doze aberturas humanas mais jogadas, nessas condições experimentais; os testes com desvantagem de tempo devem ser distinguidos desse resultado.
Os números de velocidade também mudam entre os artigos e merecem ser citados juntos, sem mistura: 80 mil posições por segundo contra 70 milhões em 2017; 60 mil contra 60 milhões em 2018. Nos dois casos, a mesma ordem de grandeza, com uma proporção próxima de um para mil.
Examinar as partidas publicadas
As partidas fornecidas com as publicações permitem estudar sacrifícios, atividade das peças e pressão sobre o rei. Para entender uma escolha, olhe a posição e as defesas disponíveis em vez de atribuir ao programa uma confiança ou intuição humana.
Uma avaliação próxima de zero não prova que um motor ignore toda iniciativa: depende da versão, da profundidade e dos recursos disponíveis. Um exemplo isolado não mede um estilo universal.
O que AlphaZero descobriu ou redescobriu nas aberturas
O impacto mais duradouro de AlphaZero na prática do xadrez não é o match em si: é a influência na teoria das aberturas.
É preciso distinguir aprender sequências de abertura de influenciar modas humanas. Os resultados publicados não demonstram que AlphaZero tenha trazido o London ou o Gambito do Rei de volta à moda. O repertório ilustrado nas partidas publicadas com as brancas gira em torno de 1.d4, 1.Cf3 e 1.c4. O Gambito do Rei começa com 1.e4 e5 2.f4: é justamente a família de aberturas da qual AlphaZero se afasta. Já o retorno do London ao alto nível é uma tendência humana, anterior e independente. Aliás, London não é uma “defesa”, mas um sistema de desenvolvimento das brancas.
O que está realmente documentado é mais interessante que a anedota:
AlphaZero redescobriu aberturas humanas sozinho. As curvas do artigo de Science mostram a frequência de cada abertura nas partidas de autoaprendizado ao longo das horas de treinamento. Sem jamais ter visto uma partida humana, convergiu para aberturas encontradas por gerações de jogadores e depois restringiu progressivamente seu repertório. Experimentou e abandonou algumas aberturas populares entre humanos.
Um teste com doze aberturas impostas. É o teste mais esclarecedor do artigo de 2018: para verificar se a força de AlphaZero não vinha de uma especialização estreita, os autores impuseram as doze aberturas humanas mais jogadas, com ambas as cores. Venceu Stockfish a partir de todas elas.
Sacrifícios posicionais e atividade das peças. É aí que a influência sobre a prática humana fica mais visível nas partidas publicadas: disposição para devolver material em troca de pressão duradoura e uso dos peões da ala do rei para conquistar espaço, em vez de apenas proteger o rei.
Lc0 é um projeto livre inspirado em AlphaZero; essa origem não garante superioridade didática sobre Stockfish.
A convergência: Stockfish NNUE e o fim da dicotomia
Em setembro de 2020, com a versão 12, Stockfish incorporou uma arquitetura de rede neural chamada NNUE, Efficiently Updatable Neural Network, introduzida no shogi por Yu Nasu em 2018 e depois adaptada ao xadrez.
NNUE substitui a função de avaliação heurística do Stockfish por uma rede treinada com milhões de posições avaliadas pelo próprio Stockfish. Sua particularidade é ser concebida para rodar rapidamente em um processador comum, sem placa gráfica. Assim, Stockfish NNUE combina a velocidade da busca alfa-beta da arquitetura anterior com a riqueza da avaliação posicional das redes neurais.
A melhora foi imediata. A equipe atribuiu somente à adoção do NNUE pelo menos 80 pontos Elo nos seus testes. Um salto considerável para um motor que chegava à décima segunda versão.
A dicotomia “Stockfish, força bruta, contra AlphaZero, aprendizado profundo” ficou ultrapassada. Avaliação neural e busca alfa-beta podem ser combinadas. Comparar dois motores exige especificar a versão, o hardware e o controle de tempo.
O que aproveitar na sua análise
Uma partida de motor pode oferecer uma ideia para conferir: atividade contra material, espaço ou segurança do rei. Depois é preciso entender as variantes. Um sacrifício bem-sucedido no protocolo publicado não é autorização geral para sacrificar em uma posição semelhante.
Comparar várias versões e condições também ajuda a ler as avaliações com cuidado. A força de um programa em um match e a explicação de um lance para um humano são duas questões diferentes.
Uma maneira de testar um sacrifício comentado
Pegue uma partida publicada em que o comentário atribua a compensação por um peão ao espaço ou à atividade. Cubra a continuação. Anote primeiro a versão mais concreta dessa afirmação que conseguir: qual peça adversária ficará sem casas, em qual coluna uma torre sua entrará e em quantos lances isso poderá acontecer? Se só puder escrever “as brancas têm iniciativa”, ainda falta uma hipótese para colocar à prova.
Depois troque de lado. Procure uma sequência que ofereça a devolução do peão para trocar justamente a torre ativa. Se essa defesa funciona, você identificou uma condição do sacrifício. Se ela falha, localize a primeira casa que falta ao defensor. O ponto instrutivo pode estar vários lances antes do desfecho espetacular escolhido para a publicação.
Por fim, compare duas análises do mesmo motor a partir da mesma posição e com o mesmo orçamento de busca. Numa, examine o lance da partida. Na outra, examine sua defesa, mesmo que a tela não a sugira entre as primeiras opções. Conserve a variante concreta que explica a diferença. Essa comparação permite aprender com um exemplo de AlphaZero sem precisar adivinhar o que a rede teria “pensado” nem tratar uma única partida como julgamento definitivo sobre um estilo de jogo.
Se o motor mudar de preferência ao receber mais tempo, salve as duas variantes com os respectivos limites de análise. Talvez a primeira sequência já contivesse a ideia estratégica correta e apenas avaliasse mal um final. Nessa situação, corrigir o comentário do sacrifício exige mostrar o final que mudou, não atribuir ao programa uma personalidade diferente.
Fontes
Silver, D., et al. (2017). Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm. arXiv. Texto.
Silver, D., et al. (2018). A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play. Science, 362, 1140–1144. Artigo e suplemento.
Equipe Stockfish (2020). Introducing NNUE Evaluation. Stockfish. Anúncio.
Equipe Stockfish (2020). Stockfish 12. Anúncio.
Projeto Lc0 (sem data). Leela Chess Zero. Apresentação e download.
Comentários