
La comparaison entre AlphaZero et Stockfish permet d'examiner différentes manières d'associer recherche, évaluation et apprentissage dans un programme d'échecs. L'intérêt ne se réduit pas au résultat d'un match : il porte aussi sur les méthodes employées et les conditions de la comparaison.
Pour comprendre ce que les parties publiées montrent, il faut distinguer les décisions visibles sur l'échiquier, le fonctionnement des programmes et les conclusions permises par le protocole. Une sélection de parties peut éclairer une méthode sans suffire à caractériser tous ses avantages.
L'architecture d'AlphaZero
Pour comprendre pourquoi AlphaZero représente une rupture, il faut comprendre ce qu'il fait, et ce qu'il ne fait pas.
AlphaZero est un système de deep reinforcement learning (apprentissage par renforcement profond). Il combine deux technologies :
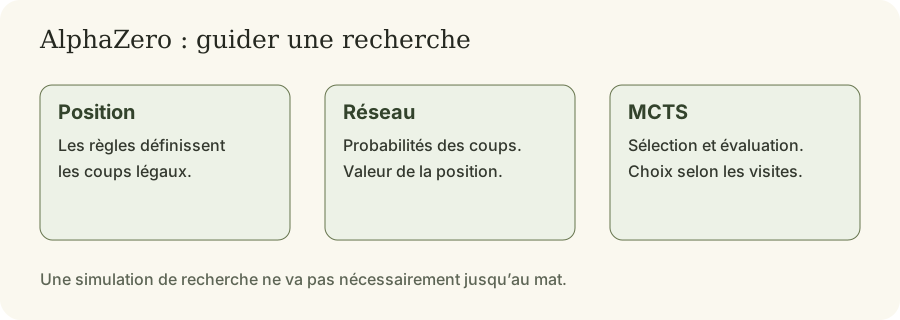
Un réseau de neurones profond qui prend en entrée la position de l'échiquier et produit deux sorties : une distribution de probabilité sur tous les coups légaux (la "policy head" : quels coups semblent prometteurs), et une valeur entre -1 et +1 estimant l’issue du point de vue du joueur au trait (la « tête de valeur »).
La recherche arborescente Monte Carlo (MCTS) qui utilise le réseau de neurones pour guider la recherche. Elle sélectionne des chemins jusqu’aux feuilles de l’arbre exploré ; le réseau y fournit une évaluation qui remonte vers la racine. Ces simulations ne sont pas toutes jouées jusqu’au mat. La recherche alpha-bêta de Stockfish est elle aussi sélective : l'opposition n'est pas entre un programme qui choisit ses variantes et un autre qui calculerait absolument tout.
Le réseau apprend sans exemples de parties humaines, sans bibliothèque d'ouvertures et sans base de finales. Cela ne signifie pas que le système émerge sans conception humaine : les chercheurs définissent les règles, la représentation des positions, l'architecture du réseau et la procédure d'apprentissage. L'absence d'une fonction d'évaluation écrite à partir de concepts échiquéens doit être distinguée de l'absence de toute connaissance utilisée pour construire le programme.
Il a joué 44 millions de parties contre lui-même en neuf heures environ, ajustant les paramètres du réseau au fil de l'entraînement. Cette durée mobilise un matériel considérable : 5 000 TPU de première génération génèrent les parties et 16 TPU de deuxième génération entraînent le réseau dans le protocole de 2018, contre 64 pour cette dernière tâche dans le préprint de 2017. Il faut distinguer ce coût d'apprentissage du matériel employé ensuite pour jouer un match. Publications de 2017 et 2018, méthodes et tableau S3.
Trois nombres qui ne répondent pas à la même question
La probabilité associée à un coup, la valeur d'une position et le nombre de visites dans l'arbre peuvent sembler interchangeables. Ils servent pourtant à des opérations distinctes. Voici un exemple numérique inventé pour l'explication, qui ne reproduit aucune sortie réelle d'AlphaZero.
Supposons que le réseau attribue trois probabilités initiales : 0,60 au coup A, 0,30 à B et 0,10 à C. Cela ne signifie pas que A gagne dans 60 % des cas. Ces nombres forment une distribution sur les coups et orientent la recherche. Une partie importante du travail consiste justement à examiner ce que les réponses adverses font à ces candidats.
Supposons ensuite que la recherche aboutisse à 18 visites pour A, 70 pour B et 12 pour C. Le candidat initialement le plus favorisé n'est plus le plus visité. Ce scénario illustre comment le réseau et l'exploration peuvent produire des préférences différentes. Les nombres ont été choisis pour rendre cette distinction visible ; ils ne décrivent ni la formule de sélection complète ni une répartition fixe à respecter.
La valeur répond encore à une autre question. Avec la convention victoire = +1, nulle = 0 et défaite = −1, une répartition hypothétique de 40 % de victoires, 50 % de nulles et 10 % de défaites aurait une valeur moyenne de 0,40 − 0,10 = 0,30. Une valeur de 0,30 n'est donc pas, à elle seule, une probabilité de victoire de 30 %. Le réseau décrit dans l'article produit une estimation scalaire ; cette décomposition est notre illustration arithmétique, pas trois probabilités qu'il afficherait nécessairement.
Le point de vue compte également. Une position favorable au joueur au trait devient défavorable à son adversaire. Lorsqu'on propage des valeurs dans une recherche alternant les deux camps, il faut conserver cette convention. Oublier ce changement reviendrait, dans une analyse humaine, à considérer le meilleur coup adverse comme s'il cherchait à nous aider. La description algorithmique de 2017 distingue la politique du réseau, les statistiques de recherche et le résultat qui sert à l'apprentissage.
Le match : 28-0-72
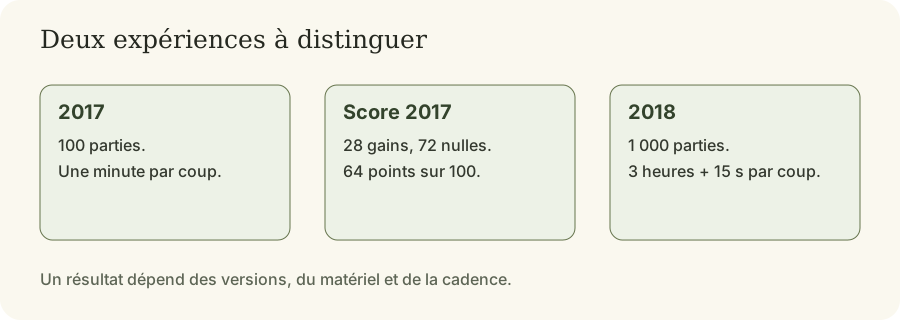
Dans le match de décembre 2017, AlphaZero a joué 100 parties contre Stockfish 8, la version choisie pour cette comparaison. Résultat : 28 victoires pour AlphaZero, 72 nulles, 0 défaite. Dans le détail : avec les Blancs, 25 victoires et 25 nulles ; avec les Noirs, 3 victoires et 47 nulles.
Ce n'était pas une cadence classique : chaque programme disposait d'une minute de réflexion fixe par coup. Cette condition empêche de répartir une réserve globale de temps en accordant davantage de réflexion à certains coups critiques. Le résultat doit donc être lu avec cette restriction de la gestion du temps.
L'absence de défaite dans cet échantillon est un résultat du match, pas une preuve d'invincibilité. Les parties publiées permettent d'examiner des idées positionnelles, mais leur sélection ne suffit pas à décrire toutes les victoires ni toutes les positions où les programmes diffèrent.
Des critiques légitimes existent sur les conditions du match :
- Stockfish tournait sans base de finales et sans bibliothèque d'ouvertures
- Son espace de hachage était limité à 1 Go, très peu pour 64 threads
- La cadence d'une minute par coup neutralisait sa gestion du temps
- Le matériel d'AlphaZero (TPU) n'est pas directement comparable aux CPU de Stockfish
La publication évaluée par les pairs dans Science, en décembre 2018, présente un protocole différent : 1 000 parties, 3 heures par partie plus 15 secondes par coup, 44 cœurs pour Stockfish, et la version de Stockfish championne du TCEC 2016.
AlphaZero remporte également ce match : 155 victoires, 6 défaites, 839 nulles sur 1 000 parties, soit environ 57,5 % du score. Il bat par ailleurs Stockfish dans les matchs commençant depuis chacune des 12 ouvertures humaines retenues, dans ces conditions expérimentales ; les essais avec handicap de temps doivent être distingués de ce résultat.
Pour calculer le score de 2017, compte une victoire comme un point et une nulle comme un demi-point : 28 + 72 ÷ 2 = 64 points sur 100. En 2018, le même calcul donne 155 + 839 ÷ 2 = 574,5 points sur 1 000, soit 57,45 %. Comparer seulement « 28 à 0 » et « 155 à 6 » fait disparaître la place des nulles. Cependant, la différence entre 64 % et 57,45 % ne mesure pas isolément un changement de force : le nombre de parties, la cadence et les configurations changent aussi.
Les chiffres de vitesse changent aussi d'un papier à l'autre, et il vaut la peine de les citer ensemble sans les mélanger : 80 000 positions par seconde contre 70 millions en 2017, 60 000 contre 60 millions en 2018. Dans les deux cas, le même ordre de grandeur, un rapport proche de 1 à 1 000.
Ces chiffres arrondis ne décrivent pas des opérations identiques. Évaluer une position avec un réseau profond et la traiter dans la recherche de Stockfish n'ont pas le même coût. Le nombre de positions par seconde ne permet donc pas de conclure qu'un système consomme mille fois moins d'énergie ou serait mille fois plus efficace. Il faut définir la ressource que l'on compare et mesurer celle-ci.
Examiner les parties publiées
Les parties fournies avec les publications permettent d'étudier des sacrifices, l'activité des pièces et la pression sur le roi. Pour comprendre un choix, regarde la position et les défenses disponibles plutôt que d'attribuer au programme une confiance ou une intuition humaine.
Une évaluation proche de zéro ne prouve pas qu'un moteur ignore toute initiative : elle dépend de sa version, de sa profondeur et des ressources disponibles. Un exemple isolé ne mesure pas un style universel.
Une séquence vérifiable : l'ouverture de la colonne g
La première partie du tableau S6 du supplément de 2018 oppose AlphaZero avec les Blancs à Stockfish. Elle commence par 1.Cf3 Cf6 2.c4 e6 3.Cc3 Fb4 4.Dc2 O-O 5.a3 Fxc3 6.Dxc3 a5 7.b4 d6 8.e3 Ce4 9.Dc2 Cg5 10.b5 Cxf3+ 11.gxf3 Df6 12.d4 Dxf3 13.Tg1. Notation publiée, partie 1 du supplément.
Examine les transformations avant d'évaluer le sacrifice. Le Cavalier noir a pris le Cavalier blanc f3 ; le pion g2 a repris en f3 ; la Dame noire a ensuite capturé ce pion. La colonne g s'est donc libérée devant la Tour h1, qui rejoint g1. La faiblesse apparente de la structure blanche s'accompagne d'une possibilité d'activité concrète.
Question d'analyse : que permet 13.Tg1, et que ne prouve-t-il pas ? La Tour vise désormais le pion g7 le long d'une colonne dégagée entre g1 et g7. Cela rend intelligible son développement. Mais constater cette pression ne démontre pas un gain forcé : le Roi blanc est encore en e1, les Noirs ont des réponses et il faut vérifier leurs défenses. Dans la partie, la suite 13…Cd7 14.Fe2 Df6 15.Fb2 Dh4 16.Tg4 illustre la poursuite de l'activité de la Tour.
La leçon proposée porte sur l'examen des échanges : quelle ligne la capture ouvre-t-elle et quelle pièce peut l'utiliser ? Elle ne consiste pas à copier 11.gxf3 dans n'importe quelle ouverture. Une position proche, avec un autre défenseur ou un temps de moins, exige une autre analyse. Aucun chiffre d'évaluation ni état mental du programme n'est déduit ici de cette seule séquence.
Ce qu'AlphaZero a (re)découvert en théorie des ouvertures
L'évolution des choix d'ouverture pendant l'apprentissage permet d'examiner une autre question : quelles séquences apparaissent lorsqu'un programme apprend par auto-jeu sans consulter de parties humaines ?
Il faut distinguer l’apprentissage de séquences d’ouverture et l’influence d’un programme sur les modes humaines. Les résultats publiés ne démontrent pas qu’AlphaZero aurait remis le London ou le Gambit du Roi à la mode. Les parties du supplément de 2018 illustrent notamment des départs blancs par 1.d4, 1.Cf3 et 1.c4. Cela ne constitue pas une étude des choix ultérieurs des joueurs humains. Au passage, le London est un système de développement des Blancs, tandis que le Gambit du Roi commence par 1.e4 e5 2.f4 : ces ouvertures ne doivent pas être confondues avec une théorie générale du sacrifice attribuée à AlphaZero.
Ce qui est réellement documenté est plus intéressant que l'anecdote :
AlphaZero a redécouvert les ouvertures humaines tout seul. Les courbes du papier de Science montrent la fréquence de chaque ouverture dans ses parties d'auto-apprentissage au fil des heures d'entraînement. Sans avoir jamais vu une partie humaine, il a convergé vers des ouvertures que des générations de joueurs avaient trouvées, puis a progressivement resserré son répertoire. Certaines ouvertures populaires chez les humains, il les a essayées et abandonnées.
Un test sur douze ouvertures imposées. C'est le test le plus parlant du papier de 2018 : pour vérifier que la force d'AlphaZero ne venait pas d'une spécialisation étroite, les auteurs lui ont imposé les 12 ouvertures humaines les plus jouées, des deux couleurs. Il a battu Stockfish depuis toutes.
Les sacrifices positionnels et l'activité des pièces. Les parties publiées fournissent des cas à étudier : rendre du matériel pour l'activité ou utiliser des pions de l'aile du Roi pour gagner de l'espace. Elles ne mesurent pas, à elles seules, l'étendue de leur influence sur les joueurs humains.
Lc0 est un projet libre inspiré d'AlphaZero ; cette filiation ne garantit pas une supériorité pédagogique sur Stockfish.
La convergence : Stockfish NNUE et la fin de la dichotomie
En septembre 2020, la version 12 de Stockfish utilise par défaut une architecture de réseau de neurones appelée NNUE (Efficiently Updatable Neural Network), d'abord développée pour le shogi puis portée aux échecs.
Dans cette version, l'évaluation neuronale et l'évaluation classique restent toutes deux disponibles. Le réseau est entraîné sur les évaluations de millions de positions. Il fonctionne efficacement sur un processeur ordinaire, notamment parce que seuls certains éléments du réseau doivent être actualisés après un coup. Stockfish combine ainsi une évaluation neuronale avec la recherche alpha-bêta. Annonce de NNUE et publication de Stockfish 12.
L'amélioration a été immédiate. Les tests de l'équipe créditaient le seul passage au NNUE d'au moins 80 points Elo dans leurs tests. Un saut considérable pour un moteur qui en était à sa douzième version.
La dichotomie "Stockfish (force brute) vs AlphaZero (deep learning)" est devenue obsolète. L’évaluation neuronale et la recherche alpha-bêta peuvent donc être combinées. Comparer deux moteurs exige de préciser leur version, le matériel et la cadence.
Ce que tu peux en tirer pour ton analyse
Une partie de moteur peut te donner une idée à vérifier : activité contre matériel, espace ou sécurité du roi. Il faut ensuite comprendre les variantes. Un sacrifice réussi dans le protocole publié n'est pas une autorisation générale de sacrifier dans une position qui lui ressemble.
Comparer plusieurs versions et conditions aide aussi à lire les évaluations avec prudence. La force d'un programme en match et l'explication d'un coup pour un joueur humain sont deux questions différentes.
Sources
-
Silver, D., et al. (2017). Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm. arXiv. Texte.
-
Silver, D., et al. (2018). A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play. Science, 362, 1140–1144. Article et supplément.
-
Équipe Stockfish (2020). Introducing NNUE Evaluation. Stockfish. Annonce.
-
Équipe Stockfish (2020). Stockfish 12. Annonce.
-
Projet Lc0 (s. d.). Leela Chess Zero. Présentation et téléchargement.
Commentaires