
Existe algo curioso em a estratégia no xadrez, jogo milenar de intuição e arte, poder ser formalizada por um algoritmo de poucas linhas. Minimax faz isso: formaliza o centro do raciocínio estratégico em um jogo de soma zero por uma recorrência matemática elegante. Não é apenas uma base dos motores: também oferece uma analogia útil para organizar seu cálculo, sem constituir uma descrição demonstrada do cérebro. Para o modelo teórico geral em que minimax é central, veja teoria dos jogos no xadrez; para o teorema que garante um valor às posições, veja o paradoxo de Zermelo.
A intuição por trás do minimax
Imagine que joga com as brancas e quer escolher o melhor lance possível. Como defini-lo? O melhor lance é aquele que, supondo que o adversário também jogue perfeitamente, oferece o melhor resultado final.
Essa definição recursiva é a essência do minimax. As brancas querem maximizar o resultado do ponto de vista delas. As pretas querem minimizá-lo nessa mesma perspectiva ou, simetricamente, maximizar o resultado na própria perspectiva. Os jogadores se alternam e, a cada nível da árvore, um deles joga.
A formalização matemática é direta:
Aqui, é a posição atual, é a profundidade de busca restante, $C(p)$ é o conjunto dos lances legais em e é a posição resultante do lance em .
A função de avaliação: o centro do motor
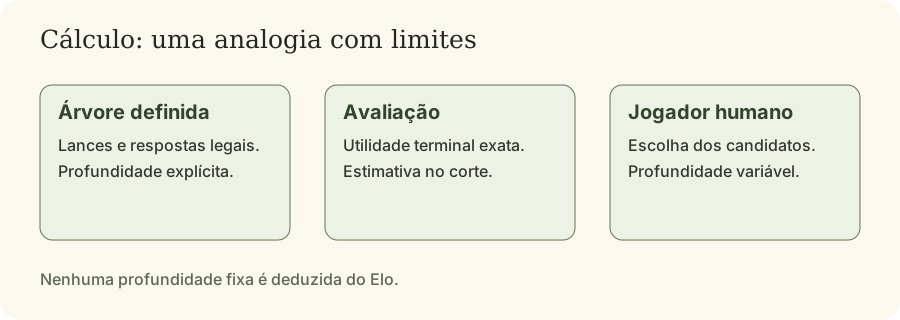
O minimax puro resolveria o xadrez perfeitamente se fosse possível explorar a árvore completa até as posições terminais. Na prática, isso não é viável devido à complexidade combinatória: a ordem de grandeza de Shannon ilustra a explosão das sequências de lances, não uma contagem exata das folhas. É preciso interromper a busca em uma profundidade finita e avaliar as posições não terminais com uma função de avaliação heurística.
Uma avaliação clássica combina características como material, mobilidade, segurança dos reis e estrutura de peões. Essas referências ajudam a ler uma posição; não constituem valores absolutos independentes do contexto.
Stockfish incorporou a avaliação neural NNUE em 2020. É preciso distinguir essa arquitetura das antigas somas de critérios escritos à mão. Na recorrência apresentada, “avaliação” deve devolver a utilidade exata de um resultado terminal e uma estimativa de uma posição apenas cortada na profundidade zero.
A poda alfa-beta: evitar uma busca inútil
O algoritmo minimax bruto tem um custo elevado. Para uma profundidade de meios-lances e um fator de ramificação , a quantidade média de lances legais, o número de folhas é da ordem de no modelo uniforme. Com e , são posições. Inviável na prática.
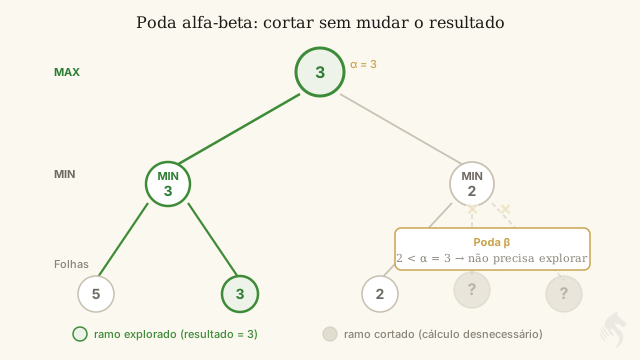
A poda alfa-beta, em francês, desenvolvida independentemente por vários pesquisadores nos anos 1950 e 1960 e formalizada por John McCarthy, em francês, reduz o custo eliminando ramos que não podem influenciar a decisão final.
O princípio: se você já encontrou uma opção para as brancas que garante um resultado de valor e explora um ramo em que as pretas podem forçar um resultado inferior a para as brancas, esse ramo pode ser abandonado. As brancas não o escolherão, pois já têm uma opção melhor.
Formalmente, são mantidos dois limites no pseudocódigo ou no quadro:
- : o melhor valor já garantido ao jogador que maximiza, as brancas
- : o melhor valor já garantido ao jogador que minimiza, as pretas
Quando , o ramo atual é podado: não pode produzir um resultado melhor que o já conhecido.
No caso ideal, com os lances ordenados por qualidade decrescente, alfa-beta reduz a ordem de grandeza para . Não é uma igualdade que forneça a quantidade exata de nós em uma posição real.
Negamax: uma simplificação da escrita
Negamax explora a identidade avaliando a posição do ponto de vista do jogador com a vez. O sinal muda quando muda o lado. É uma reformulação possível do minimax, não uma descrição de todos os motores nem uma garantia de reduzir o código por uma quantidade precisa de linhas.
Null-move pruning: passar a vez para economizar tempo
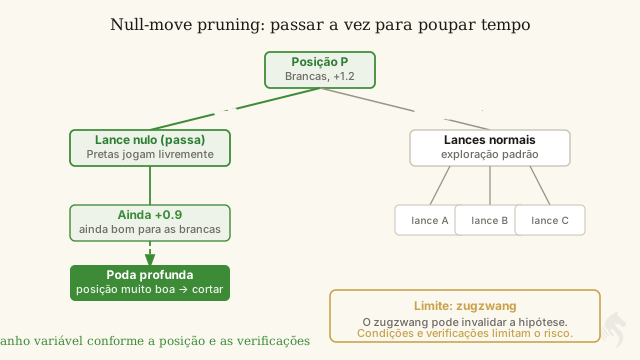
Uma heurística poderosa: e se você passar a vez? Se a posição continuar boa apesar desse lance gratuito para o adversário, provavelmente é muito boa, e você pode podar uma parte considerável da análise. É o null-move pruning, técnica comum desde os anos 1990. No xadrez, há um limite conhecido, o zugzwang: situações em que qualquer lance piora a posição, típicas de finais de peões. Por isso, as implementações acrescentam condições e verificações para limitar o risco. Nenhum ganho universal de velocidade de duas a quatro vezes é estabelecido aqui.
Técnicas avançadas dos motores modernos
Motores modernos como Stockfish acrescentam várias técnicas à poda alfa-beta básica:
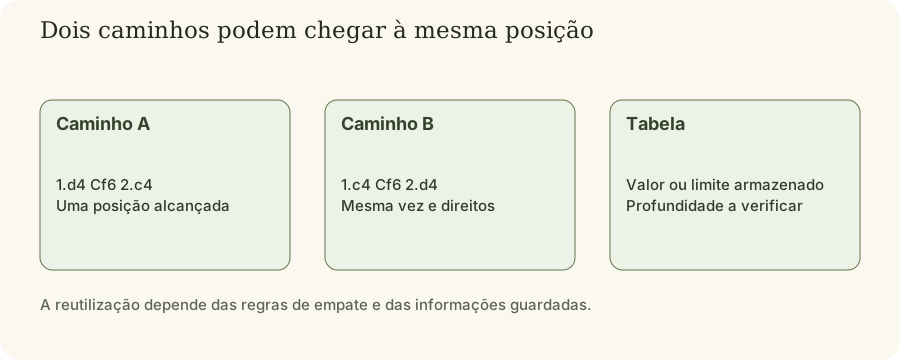
Tabelas de transposição: um cache das posições já analisadas. Se a mesma posição é alcançada por ordens de lances diferentes, uma transposição, o motor reutiliza a análise anterior em vez de recalcular. As tabelas podem economizar ordens de grandeza em tempo de cálculo.
Aprofundamento iterativo: em vez de buscar diretamente até a profundidade , o motor faz buscas sucessivas em 1, 2, 3, ..., . Cada iteração oferece uma ordenação melhor de lances para a seguinte, favorecendo a eficiência da poda.
Busca de quiescência: na profundidade máxima, em vez de avaliar estaticamente, a busca continua em certos lances táticos conforme a implementação; uma posição em xeque exige respostas legais, não apenas capturas. Isso evita avaliar uma posição em que uma troca ainda não resolvida distorceria a avaliação.
Extensões de busca: em certas posições, como mate próximo, peão passado avançado ou posição crítica, a profundidade é estendida além do limite nominal para evitar o efeito horizonte.
Reduções de busca, LMR: em sentido contrário, para lances pouco promissores, late move reduction, a profundidade é reduzida para economizar tempo. Se os lances parecem melhores que o previsto, a profundidade é restaurada.
Uma busca em evolução
O código publicado de Stockfish combina busca, tabelas de transposição, aprofundamento iterativo e vários mecanismos seletivos. Eles não devem ser confundidos com a poda alfa-beta exata em uma árvore fixa.
O anúncio NNUE de 2020 ilustra outra evolução: mudar a avaliação sem abandonar a família de busca alfa-beta. O motor moderno não se reduz, portanto, a uma fórmula de material seguida de exploração cega.
AlphaZero e as alternativas ao minimax
Em 2017, a DeepMind, em francês publicou os resultados de AlphaZero, em francês, um programa que aprendeu a jogar por autojogo em algumas horas e venceu Stockfish de maneira convincente.
AlphaZero não usa minimax clássico, mas uma busca em árvore Monte Carlo, em francês, MCTS, guiada por uma rede neural profunda. Em vez de explorar exaustivamente a árvore com poda, MCTS explora ramos promissores conforme uma política aprendida.
O que chamou a atenção não foi apenas o desempenho, mas o estilo. AlphaZero joga de maneira ousada e criativa, com sacrifícios de material de longo prazo e preferência pela atividade das peças em relação a vantagens materiais imediatas. Esse estilo lembra mais um humano intuitivo que um motor de força bruta.
AlphaZero associa aprendizado por reforço e busca MCTS, uma arquitetura diferente da busca alfa-beta clássica. Sua pontuação em um match não mede uma “compreensão mais profunda” nem a distância até a estratégia ótima. Os protocolos estão em AlphaZero e Stockfish, os custos de busca em os limites do cálculo e os limites da analogia do caos em teoria do caos no xadrez.
Minimax como ferramenta para seu cálculo
Ao pensar “se jogo aqui, qual é a melhor resposta dele?”, você pode usar minimax como perspectiva de análise. Isso não demonstra que o cérebro execute o procedimento nem permite atribuir de três a oito ou de sete a dez níveis a uma categoria de jogadores.
Em uma posição de treinamento, escolha dois lances candidatos e examine uma resposta adversária a cada um. Depois procure uma defesa que não havia considerado. O objetivo é melhorar a verificação, não reproduzir uma medida de profundidade humana.
Um nó da árvore que você pode conferir no papel
Imagine uma árvore inventada com três lances das brancas. Ao final das linhas consideradas, A oferece resultados de mais três ou menos dois; B oferece mais um ou zero; C oferece mais dois ou menos quatro. Todos os números estão expressos do ponto de vista das brancas. Em cada ramo as pretas escolhem o menor resultado disponível. Restam, portanto, menos dois para A, zero para B e menos quatro para C. As brancas escolhem B.
Agora acrescente, apenas em B, uma defesa das pretas que produz menos três. A escolha inicial muda para A. Nenhum valor antigo precisou mudar: foi o conjunto de respostas examinadas que mudou. No tabuleiro, esse é um bom motivo para anotar a defesa adversária que você descartou cedo demais, além do próprio lance errado. A regra minimax pode estar impecável mesmo quando a árvore desenhada pelo jogador está incompleta.
O mesmo exemplo com empate aceitável
Se um empate bastar para ganhar o torneio, a decisão prática pode depender do relógio e da dificuldade de execução. Para testar essa pergunta diferente, você teria de alterar a definição de resultado no modelo. Trocar uma avaliação numérica pela sua preferência pessoal depois de ver a resposta muda o problema no meio do cálculo.
Anote os valores ao lado de cada resposta adversária. Isso permite recuperar qual escolha efetivamente limita o resultado em cada ramo.
Fontes
- Russell, S., & Norvig, P. (sem data, capítulo on-line). Adversarial Search. Artificial Intelligence: A Modern Approach. Capítulo.
- Equipe Stockfish (sem data). search.cpp. Repositório oficial Stockfish. Código.
- Equipe Stockfish (2020). Introducing NNUE Evaluation. Anúncio.
- Silver, D., et al. (2017). Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm. arXiv. Artigo.
Comentários