
Tu connais ton classement, mais tu estimes peut-être qu’il ne reflète pas tout à fait ton niveau. Cette impression peut avoir des raisons concrètes. Elle mérite aussi d’être confrontée à autre chose qu’à tes meilleures parties.
Une étude de 2025 permet d’aborder la surconfiance aux échecs avec des données. Elle ne transforme pas chaque joueur qui se sent sous-classé en exemple d’un défaut psychologique.
Les 3 388 joueurs sont bien réels
Heck, Benjamin, Simons et Chabris publient deux études préenregistrées dans Psychological Science. Leur échantillon combiné comprend 3 388 joueurs classés de 22 pays, âgés de 5 à 88 ans, avec en moyenne 18,8 ans d’expérience en tournoi.
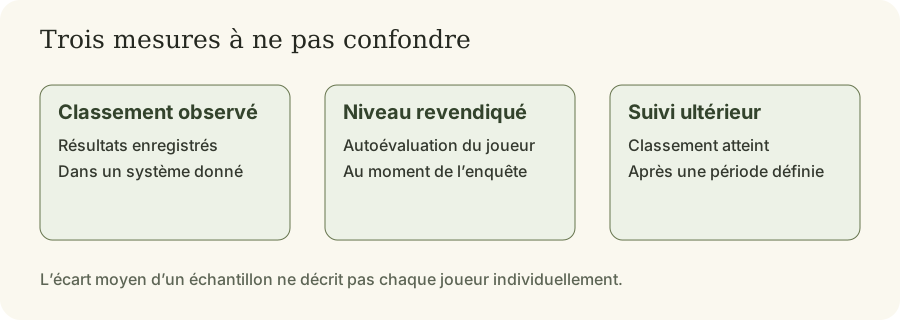
Les participants s’attribuent en moyenne un niveau supérieur de 89 points Elo à leur classement observé. La surestimation est plus forte parmi les joueurs moins bien classés ; les mieux classés sont mieux calibrés dans cet échantillon.
Un an plus tard, 11,3 % des joueurs qualifiés de surconfiants ont atteint le classement revendiqué. Ce résultat décrit ce groupe et ce suivi. Il ne signifie pas que toi, aujourd’hui, tu as exactement 88,7 % de chances de te tromper.
Une moyenne n’est pas un portrait individuel
Le décalage moyen de 89 points ne dit pas que tout le monde se surestime de cette quantité. Un joueur peut progresser, manquer de parties récentes ou varier selon les cadences. L’étude reste informative sans faire du classement une mesure parfaite et permanente de chaque compétence.
De même, une espérance de score calculée à partir d’un écart Elo n’est pas un nombre garanti de victoires. Les nulles contribuent au score, et une courte série varie beaucoup.
Le titre de l’étude parle de surconfiance persistante. Il ne démontre pas, à lui seul, que chaque mécanisme proposé pour expliquer l’effet Dunning-Kruger est confirmé.
Pourquoi la forme du graphique compte
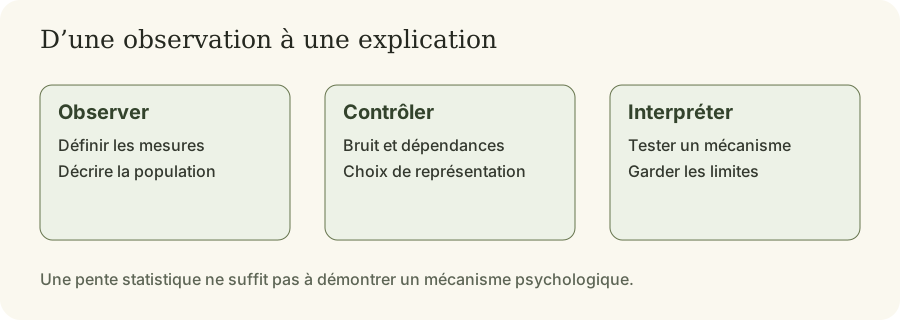
Nuhfer et ses collègues (2016) étudient l’influence du bruit et des conventions graphiques sur l’autoévaluation. Leurs simulations montrent notamment que certaines représentations favorisent des interprétations trompeuses.
Relier la compétence mesurée à un écart qui contient cette même mesure peut créer une dépendance mathématique. Voir une pente sur un graphique ne suffit donc pas à identifier une incapacité psychologique à reconnaître son niveau.
Ce travail ne fait pas disparaître toute surconfiance. Il rappelle que les erreurs d’évaluation et leur explication sont deux questions à examiner séparément. Il s’agit ici de la publication de 2016 ; aucune seconde publication de 2017 n’est nécessaire au raisonnement retenu.
Te donner un retour plus utile
Si tu penses être sous-classé, écris ce que tu attends de tes prochaines parties et dans quelles conditions. Compare ensuite une série suffisamment documentée à cette attente. Garde les défaites, les nulles et les victoires, sans modifier les critères après coup.
Tu peux aussi faire commenter une partie par quelqu’un qui explique ses objections. Une variante concrète est plus instructive qu’un jugement comme « tu manques d’humilité ».
L’analyse des parties et la rationalisation prolongent ce travail. Si ton problème est surtout de ne pas te sentir légitime malgré tes résultats, lis plutôt l’article sur le syndrome de l’imposteur. Les deux questions peuvent coexister ; elles ne permettent pas de poser un diagnostic à distance.
Comment un découpage fabrique un écart dans un petit exemple
Un entraîneur prépare un test de quatre positions, puis demande à quatre élèves de prévoir leur résultat. Tous répondent qu'ils réussiront deux positions sur quatre. Leurs résultats réels sont un, deux, deux et trois. L'élève arrivé dernier a donc surestimé son résultat d'un exercice. Celui arrivé premier l'a sous-estimé d'autant. Si l'on présente seulement les deux extrêmes, le lecteur pourrait croire qu'il existe deux types de joueurs, l'un trop sûr de lui, l'autre trop modeste. Pourtant, les quatre élèves avaient exactement la même prévision.
Cet exemple fabriqué ne réfute aucune étude. Il montre ce que produit une opération précise : classer les personnes d'après le résultat qui va aussi servir au calcul de leur erreur. Dans notre groupe, la prévision commune se trouve mécaniquement au-dessus du résultat le plus faible et en dessous du plus fort. Il faudrait davantage d'observations pour expliquer pourquoi les élèves ont annoncé deux, connaître leur expérience du format et savoir si leur jugement deviendrait plus précis avec une autre série de positions.
Fais varier une condition. Chaque élève annonce maintenant une fourchette allant d'un à trois exercices réussis. Les quatre prévisions contiennent le résultat. Doit-on en déduire que tout le monde se connaît parfaitement ? Pas davantage. L'intervalle couvre trois des cinq scores possibles. Une fourchette très large permet facilement de tomber juste, mais elle renseigne peu l'entraîneur qui doit choisir la difficulté de l'atelier suivant. Une estimation a donc au moins deux propriétés utiles : sa proximité avec le résultat et le degré de précision qu'elle prétend atteindre.
L'échelle compte autant que la réponse
Imagine deux membres d'un club qui disent chacun : « Je suis dans la première moitié. » L'un se compare aux joueurs qui viennent au cours du mercredi. L'autre pense à tous les inscrits du club, y compris les enfants débutants. Une même position sur une échelle verbale peut désigner deux rangs très différents. Avant d'interpréter l'écart entre une estimation et une place réelle, demande quelle population chacun avait en tête. Sixième sur dix-huit participants présents n'est pas sixième sur une liste de quatre-vingts adhérents.
Il en va de même lorsque tu veux comparer ton classement de blitz en ligne à ton expérience en tournoi classique. Le nombre apparaît dans les deux cas à côté de ton nom, mais les adversaires, la cadence et la période d'observation changent. Une différence numérique peut simplement répondre à deux questions différentes. Pour examiner ta capacité à t'estimer, commence par fixer la même question des deux côtés du calcul. Combien de points penses-tu marquer dans ces quatre parties lentes contre ces quatre partenaires ? Une fois les parties jouées, tu peux comparer ta prévision au score obtenu, en gardant à l'esprit la taille minuscule de l'échantillon.
Un autre joueur pourrait répondre honnêtement « entre un point et trois points ». Tu peux lui demander quelles circonstances lui feraient choisir le milieu de la fourchette. S'il connaît rarement les finales de tours qui apparaissent dans son ouverture, il a identifié une incertitude spécifique. S'il attend de voir s'il sera en forme le dernier jour, il parle d'une condition de jeu. Aucun de ces renseignements ne se réduit au mot « surconfiant ». Ils n'appellent d'ailleurs pas le même entraînement.
Calibrer le jugement là où il sert pendant la partie
La prévision la plus utile au joueur est parfois toute petite. Reprends une position où tu as jugé un pion impossible à prendre. Cache la suite, puis écris une affirmation que l'on pourra vérifier : « Si je prends avec le fou, l'adversaire dispose d'un échec qui gagne ma dame. » Vérifie seulement cette branche. L'échec existe-t-il ? Le roi dispose-t-il d'une case qui protège encore la dame ? Un échange préalable change-t-il la diagonale ? Tu remplaces un pronostic global sur ta valeur par un avis contrôlable sur trois cases.
Au fil de quelques séances, conserve aussi les cas où tu avais vu juste. Si tu enregistres uniquement les erreurs, une liste de huit mauvaises prévisions te dira que tu connais huit exemples intéressants, mais elle ne te donnera pas la fréquence à laquelle tes jugements échouent. Pour estimer cette fréquence dans un exercice borné, décide d'avance de conserver les dix prochaines positions proposées par ton partenaire. Note séparément les paris sur lesquels tu étais sûr de toi et ceux pour lesquels tu hésitais. Si tu n'as presque jamais utilisé l'une des catégories, attends d'avoir davantage de cas avant d'en faire une comparaison.
Le résultat peut être asymétrique. Tu peux très bien identifier les finales où tu sais ce que tu fais et te surestimer surtout dans les positions tactiques à rois exposés. La correction pertinente sera alors de tester une réponse forcée de plus dans ces positions, ou de consacrer un entraînement aux échecs intermédiaires. S'ordonner de « devenir humble » ne dit rien sur la pièce qu'il faudra vérifier au prochain coup.
Pour clore l'atelier, refais les quatre positions du départ avec des variantes légèrement modifiées. Précise à l'avance ce qu'il faut réussir : trouver le premier coup seulement ou démontrer la défense adverse jusqu'au bout. Si le barème change entre les deux essais, une progression apparente peut venir du correcteur. Un joueur qui a trouvé la bonne idée et oublié la dernière reprise a besoin de savoir si son erreur concernait le choix du candidat ou la vérification de la dernière position.
Ces précautions rendent aussi les retours d'un entraîneur plus utiles. Tu peux lui demander de noter séparément le diagnostic initial et la justification donnée devant l'échiquier. Un bon diagnostic avec une variante impossible ne vaut pas une démonstration correcte. Une mauvaise estimation de la position suivie d'une réfutation précise marque au contraire une découverte intéressante. Le carnet conserve ces différences, même si le score brut des quatre exercices est resté absolument identique.
Un partenaire peut ensuite reprendre tes feuilles avec les noms masqués. Demande-lui simplement quelle compétence il ferait travailler à chaque auteur. S'il recommande des exercices distincts à deux personnes ayant le même score, vous aurez retrouvé une information que ni le rang dans le groupe ni la seule confiance déclarée ne pouvaient fournir.
Sources
- Heck, P. R., Benjamin, D. J., Simons, D. J. et Chabris, C. F. (2025), « Overconfidence Persists Despite Years of Accurate, Precise, Public, and Continuous Feedback: Two Studies of Tournament Chess Players », Psychological Science, 36(9), 732–745. Résumé des auteurs, DOI : 10.1177/09567976251360747.
- Nuhfer, E., Cogan, C., Fleisher, S., Gaze, E. et Wirth, K. (2016), « Random Number Simulations Reveal How Random Noise Affects the Measurements and Graphical Portrayals of Self-Assessed Competency », Numeracy, 9(1), article 4. Résumé et publication, DOI : 10.5038/1936-4660.9.1.4.
Commentaires